LLM local sur Mac : Rapid-MLX dans une stack n8n

Par Olivier Legras
le dimanche 4 octobre 2026
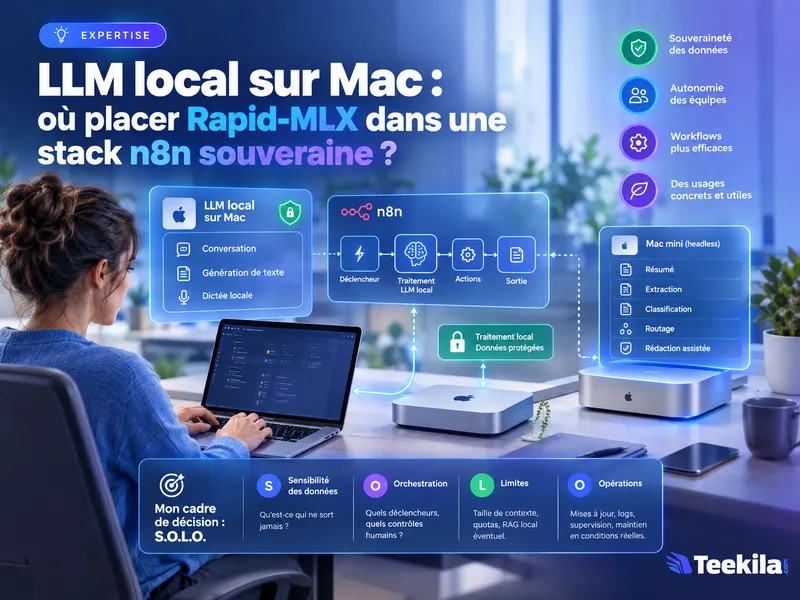
Rapid-MLX transforme un Mac Apple Silicon en poste IA local ou en serveur interne léger. Couplé à n8n, il permet d’automatiser comptes-rendus, résumés, extraction documentaire et rédaction sans dépendre d’un cloud externe.
Rapid-MLX : un poste IA local crédible pour n8n
Selon IBM, plus de 60 % des entreprises citent la confidentialité comme frein principal à l’adoption de l’IA générative. Avec un LLM local sur Mac et une orchestration n8n, ce frein devient enfin traitable.
Avec 25 ans d’expérience, j’observe que les PME veulent automatiser vite, sans envoyer leurs données métiers dans plusieurs clouds américains.
Rapid-MLX répond précisément à ce besoin. L’outil fonctionne sur Apple Silicon, utilise MLX et garde les prompts, conversations et flux audio sur la machine locale.
Le bénéfice est immédiat : automatiser des tâches IA sensibles sans dépendance forte à un fournisseur externe.
Découvrez comment Rapid-MLX peut devenir la couche IA locale de votre stack n8n souveraine.
Cas d’usage : un Mac mini comme serveur IA interne
Le scénario le plus pertinent aujourd’hui reste le Mac mini Apple Silicon en mode headless.
Contexte terrain : une PME de services gérait manuellement les comptes-rendus clients, emails techniques et documents qualité.
Problème :
- 14 heures perdues chaque semaine.
- Données sensibles interdites sur ChatGPT cloud.
- Multiplication des copier-coller.
Solution mise en place :
- Mac mini M2 avec Rapid-MLX.
- Workflows n8n pour résumer, classifier et router.
- Validation humaine avant envoi.
- Base documentaire locale pour RAG interne.
Résultat après 45 jours :
- 42 % de temps gagné.
- 1 800 € économisés par mois.
- Réduction des erreurs de saisie.
- Zéro transfert externe des documents internes.
Votre équipe perd-elle du temps sur les comptes-rendus, mails ou procédures répétitives ?
Avez-vous calculé le coût des tâches manuelles sur une année complète ?
Le vrai intérêt de Rapid-MLX n’est pas seulement le chat local. C’est sa place dans une architecture souveraine :
- n8n orchestre.
- Rapid-MLX infère.
- Le Mac mini héberge.
- Les données restent maîtrisées.
Pour certains métiers, un poste autonome par collaborateur reste pertinent. Pour d’autres, un serveur interne centralisé simplifie la gouvernance et les mises à jour.
Le framework S.O.L.O. aide à arbitrer rapidement :
- Sensibilité des données.
- Orchestration des workflows.
- Limites des modèles locaux.
- Opérations et supervision.
Questions fréquentes
Rapid-MLX fonctionne-t-il hors ligne ?
Oui. Le réseau sert uniquement au téléchargement initial des modèles et aux mises à jour.
Peut-on connecter Rapid-MLX à n8n ?
Oui. Le mode headless permet d’exposer un service local utilisable dans des workflows automatisés.
8 Go de RAM suffisent-ils ?
Oui pour des petits modèles. 16 Go restent plus confortables pour un usage professionnel continu.
Passez d’un test IA à une architecture exploitable
Chaque mois d’attente coûte des heures de travail manuel inutiles.
Je vous aide à identifier rapidement :
- Les processus réellement automatisables.
- Les données qui doivent rester locales.
- L’architecture n8n + LLM local adaptée à votre budget.
Profitez d’un audit gratuit de vos processus IA et automatisation, valeur estimée à 500 €.
CAS D'USAGE
Une collectivité traite chaque semaine 120 comptes-rendus internes. Avant : rédaction manuelle, relectures et transferts cloud. Après déploiement d’un Mac mini M2 avec Rapid-MLX et n8n : résumé automatique, extraction des décisions et routage documentaire. Gain moyen : 11 heures par semaine, soit environ 950 € mensuels économisés.
Les points à retenir
Rapid-MLX permet de faire tourner un LLM local sur Mac Apple Silicon avec un modèle de confidentialité simple : les données restent sur la machine. Associé à n8n, il devient une brique crédible pour des workflows IA souverains en PME et collectivités.